4 Min. Lesezeit
Riesige Datenbanken, weniger Tokens: der überarbeitete MCP-Server von l8db
Wie der MCP-Server von l8db KI-Assistenten durch Datenbanken mit zehntausenden Tabellen führt, ohne den Kontext zu fluten. Mit Vorgehen und Messwerten.
Von Leon Achteresch
KI-Assistenten wie Claude, Cursor oder Codex arbeiten über den MCP-Server von l8db mit deinen Datenbanken. Bei kleinen Datenbanken lief das gut, bei sehr großen wurde es teuer und langsam. Hier liest du, was ich geändert habe, wie ich vorgegangen bin und was die Messungen zeigen.
Das Problem
Manche Datenbanken haben zehntausende Tabellen, Millionen Spalten und tausende Funktionen. Ein Assistent hat aber nur begrenzt Kontext, und jedes Token kostet Geld und Zeit. Bisher ging viel davon für Schema-Listen, ganze Quelltexte und Zwischenergebnisse drauf. Allein die Liste der Werkzeuge kostete jede Sitzung rund 7.000 Tokens, bevor du überhaupt eine Frage gestellt hattest.
Die Idee
Vorbild war Cloudflares Code Mode: Die große Beschreibung bleibt außerhalb des Kontexts. Die KI fragt gezielt nach, und für Aufgaben in mehreren Schritten schreibt sie ein kleines Programm, das in einer Sandbox läuft. Zurück kommt nur das Ergebnis. Bei l8db ist diese große Beschreibung der Datenbankkatalog.
Wie ich vorgegangen bin
Erst messen, dann bauen. Die Arbeit lief in vier Phasen. Jede Phase bekam ein unabhängiges Review und danach eine Fix-Runde.
- Messen und verschlanken. Ein Token-Benchmark löst feste Aufgaben auf einem künstlichen Katalog mit 50.000 Tabellen, rund 2 Millionen Spalten und 20.000 Routinen. Er hat zuerst den Ausgangszustand festgehalten. Danach wurden die Tool-Beschreibungen kompakter und die Suche schneller: Sie sortiert die Treffer nach Relevanz und zeigt nur die passenden Spalten.
- Überblick. Das neue Werkzeug
overviewist eine Landkarte der Datenbank. Funktionen, Prozeduren und Views sind jetzt durchsuchbar, ihre Quelltexte kommen nur in Ausschnitten. Die Suche findet auch Zeilen im Quelltext, etwa für die Frage „Wer schreibt in diese Tabelle?“. Der Katalog wird zwischengespeichert, auch auf der Platte. Und das KI-Wissen, also die Beschreibungen und das Glossar, die du in l8db zu deiner Datenbank hinterlegst, ruft die KI bei Bedarf ab, statt es bei jeder Anfrage mitzuschicken. - Code Mode. Mit dem neuen Werkzeug
codeschreibt die KI eine kleine JavaScript-Funktion. Sie läuft nur lesend in einem eigenen, abgeschotteten Prozess (QuickJS), ohne Netz, ohne Dateien und ohne Zugangsdaten. Jede Abfrage darin durchläuft dieselben Prüfungen und Maskierungen wie sonst auch. - Feinschliff und Praxistest. Neuere MCP-Clients bekommen Cache-Hinweise, und den Überblick gibt es zusätzlich als Resource. Zum Schluss liefen Tests gegen echte Server per Docker: MySQL 8.4, ClickHouse 25.8, SQL Server (Azure SQL Edge) und Oracle 23ai Free. PostgreSQL 17 war schon in Phase 2 dran.
Die Zahlen
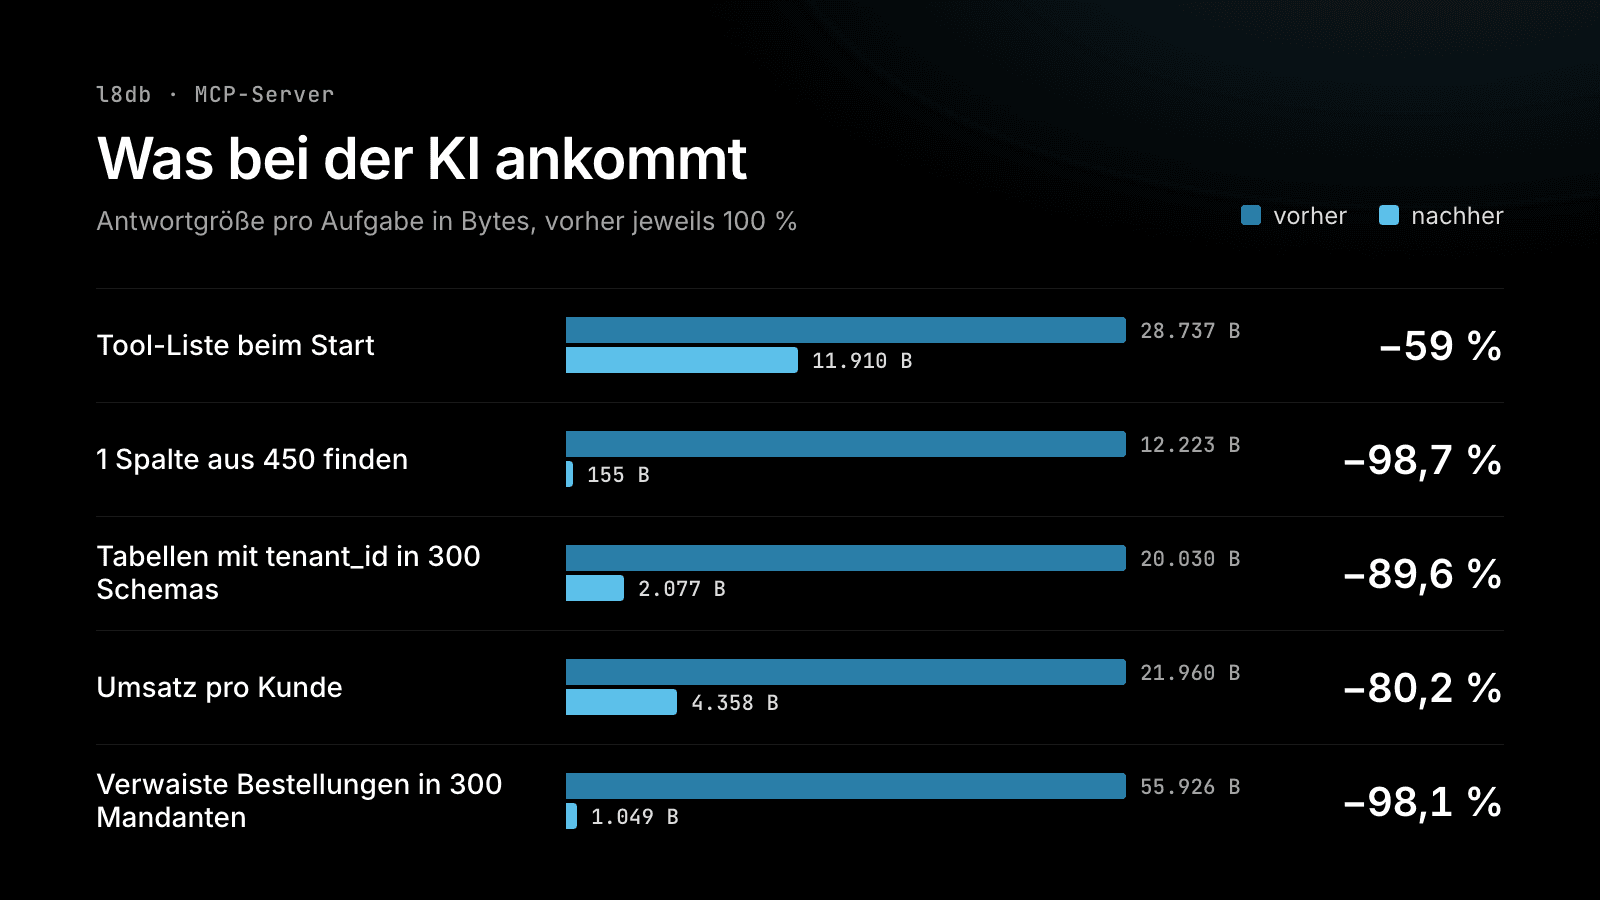
Die meisten Zeilen zeigen, wie viele Bytes bei der KI ankommen. Als Faustregel sind 4 Bytes etwa ein Token. „Modelliert“ heißt: Dafür gab es vorher kein eigenes Werkzeug, und der Wert vorher zeigt, wie eine KI die Aufgabe über SQL auf den Systemkatalogen gelöst hätte. Die letzten beiden Zeilen sind Laufzeiten.
| Messung | vorher | nachher | Änderung |
|---|---|---|---|
| Tool-Liste beim Start | 28.737 B (≈ 7.200 Tokens) | 11.910 B (≈ 3.000 Tokens) | −59 % |
| 1 Spalte aus 450 finden | 12.223 B | 155 B | −98,7 % |
Tabellen mit tenant_id in 300 Schemas | 20.030 B | 2.077 B | −89,6 % |
| Umsatz pro Kunde (vorher unvollständig) | 21.960 B | 4.358 B | −80,2 % |
| Verwaiste Bestellungen in 300 Mandanten (301 Aufrufe → 1) | 55.926 B | 1.049 B | −98,1 % |
| Routine mit 5.211 Zeilen verstehen (modelliert) | 136.626 B | 3.960 B | −97,1 % |
Wer schreibt in payments? (modelliert) | 144.448 B | 2.346 B | −98,4 % |
| KI-Wissen im Systemprompt pro Anfrage | 24.056 B | 465 B | −98 % |
| Suche in 1,98 Mio. Spalten (Median) | 6–18 s | 0,19 s | ≈ −97 % |
| Prüfung pro SQL-Anweisung (Median) | 136 ms | 0,17 ms | −99,9 % |
Ehrlich dazu: Gemessen habe ich im Debug-Build auf einem Apple M3 (macOS, 16 GB) mit dem künstlichen Katalog. Die Tokens sind geschätzt. Windows und der Release-Build sind noch nicht gemessen.
Sicherheit
Die Reviews und die Tests gegen echte Server haben mehrere Lücken in der Leseprüfung gefunden, auch ältere. Alle sind vor der Veröffentlichung behoben. Ausgeliefert werden die Korrekturen mit dem nächsten Release. Ein Datenbankbenutzer, der nur lesen darf, bleibt für den MCP-Zugang trotzdem empfehlenswert.
Was du davon hast
Die KI findet sich in großen Datenbanken schneller zurecht. Sie braucht weniger Tokens, und das spart dir Kosten und Wartezeit. Ihre Antworten sind außerdem vollständiger, wie beim Umsatz pro Kunde oben.
Die Neuerungen kommen mit dem nächsten Release von l8db.